Build real-time voice applications with Amazon SageMaker AI and vLLM
📊 Level ⭐⭐⭐⭐⭐ | 21.2KB
核心要点
- 使用 SageMaker AI 双向流式推理 + vLLM Realtime API 部署实时语音转录服务
- 支持 Voxtral-Mini-4B-Realtime-2602 等流式语音模型
- 全托管基础设施,无需自建流式处理服务
- 适用于语音 agent、实时字幕、呼叫中心分析、无障碍工具
- vLLM 开源模型 serving 层 + SageMaker AI 托管基础设施的组合方案
技术背景与问题动机
传统 request-response 推理的局限性
传统 ASR(自动语音识别)推理采用 request-response 模式:客户端必须先上传完整音频文件,服务器接收完全部数据后才能开始处理。这种模式在以下场景存在根本性问题:
- 语音 agent:用户期望实时响应,等待完整音频上传会导致明显的延迟体验
- 实时字幕:会议或直播场景下,转录必须与语音同步输出
- 呼叫中心分析:需要实时监控通话质量或触发实时干预
- 无障碍工具:听障用户依赖实时转录,延迟直接影响使用体验
解决方案:双向流式推理
2025年11月,Amazon SageMaker AI 推出双向流式实时推理,支持客户端与模型容器之间的双向持续数据流。同时,vLLM 的 Realtime API 提供原生 WebSocket 端点 /v1/realtime,实现了音频流式输入与转录增量输出的能力。
这两个能力的结合,使得从语音输入到转录输出的端到端延迟可以低至数百毫秒级别
架构深度解析
三层连接架构
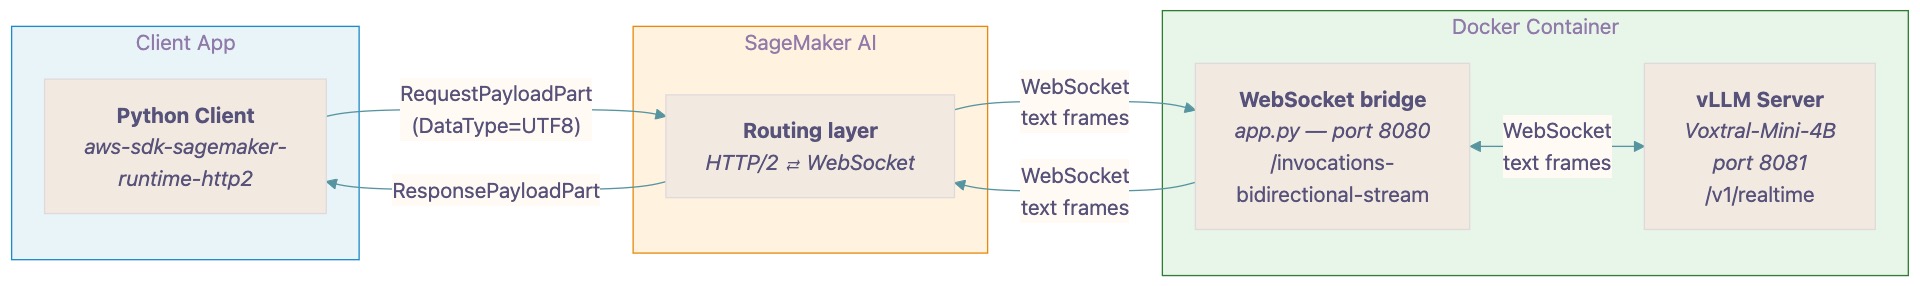
该解决方案涉及三层架构 :
Layer 1 - Client → SageMaker AI Runtime(HTTP/2)
客户端通过 HTTP/2 连接到 SageMaker AI Runtime 端点的 8443 端口。HTTP/2 支持多路复用和双向流式传输。vLLM Realtime 协议的 JSON 消息(如 input_audio_buffer.append、transcription.delta)封装在 RequestPayloadPart 中,DataType 设置为 "UTF8",指示 SageMaker AI 将数据作为 WebSocket text frame 转发。响应通过 ResponsePayloadPart 事件返回。
Layer 2 - SageMaker AI → Docker Container(协议桥接)
SageMaker AI 自动完成 HTTP/2 事件流与 WebSocket 协议的桥接。它在容器端建立 WebSocket 连接至 ws://localhost:8080/invocations-bidirectional-stream(SageMaker AI 预期的双向流路径),并在两个方向上转发数据帧。设置 DataType="UTF8" 时,桥接器向容器发送 WebSocket text frame。
Layer 3 - Docker Container 内部(FastAPI Bridge + vLLM)
容器内运行轻量级 FastAPI 应用(app.py)监听 8080 端口的 /invocations-bidirectional-stream 路径。当接收到 SageMaker AI 的 WebSocket 连接时,它建立到 vLLM Realtime API(ws://localhost:8081/v1/realtime)的第二个 WebSocket 连接,并双向转发消息。FastAPI Bridge 负责路径转换:/invocations-bidirectional-stream → /v1/realtime。同时代理 /ping 健康检查到 vLLM 的 /health 端点,满足 SageMaker AI 托管契约。
vLLM 服务器运行在 8081 端口,服务于默认的 /v1/realtime WebSocket 端点,无需修改源码
Realtime API 协议详解
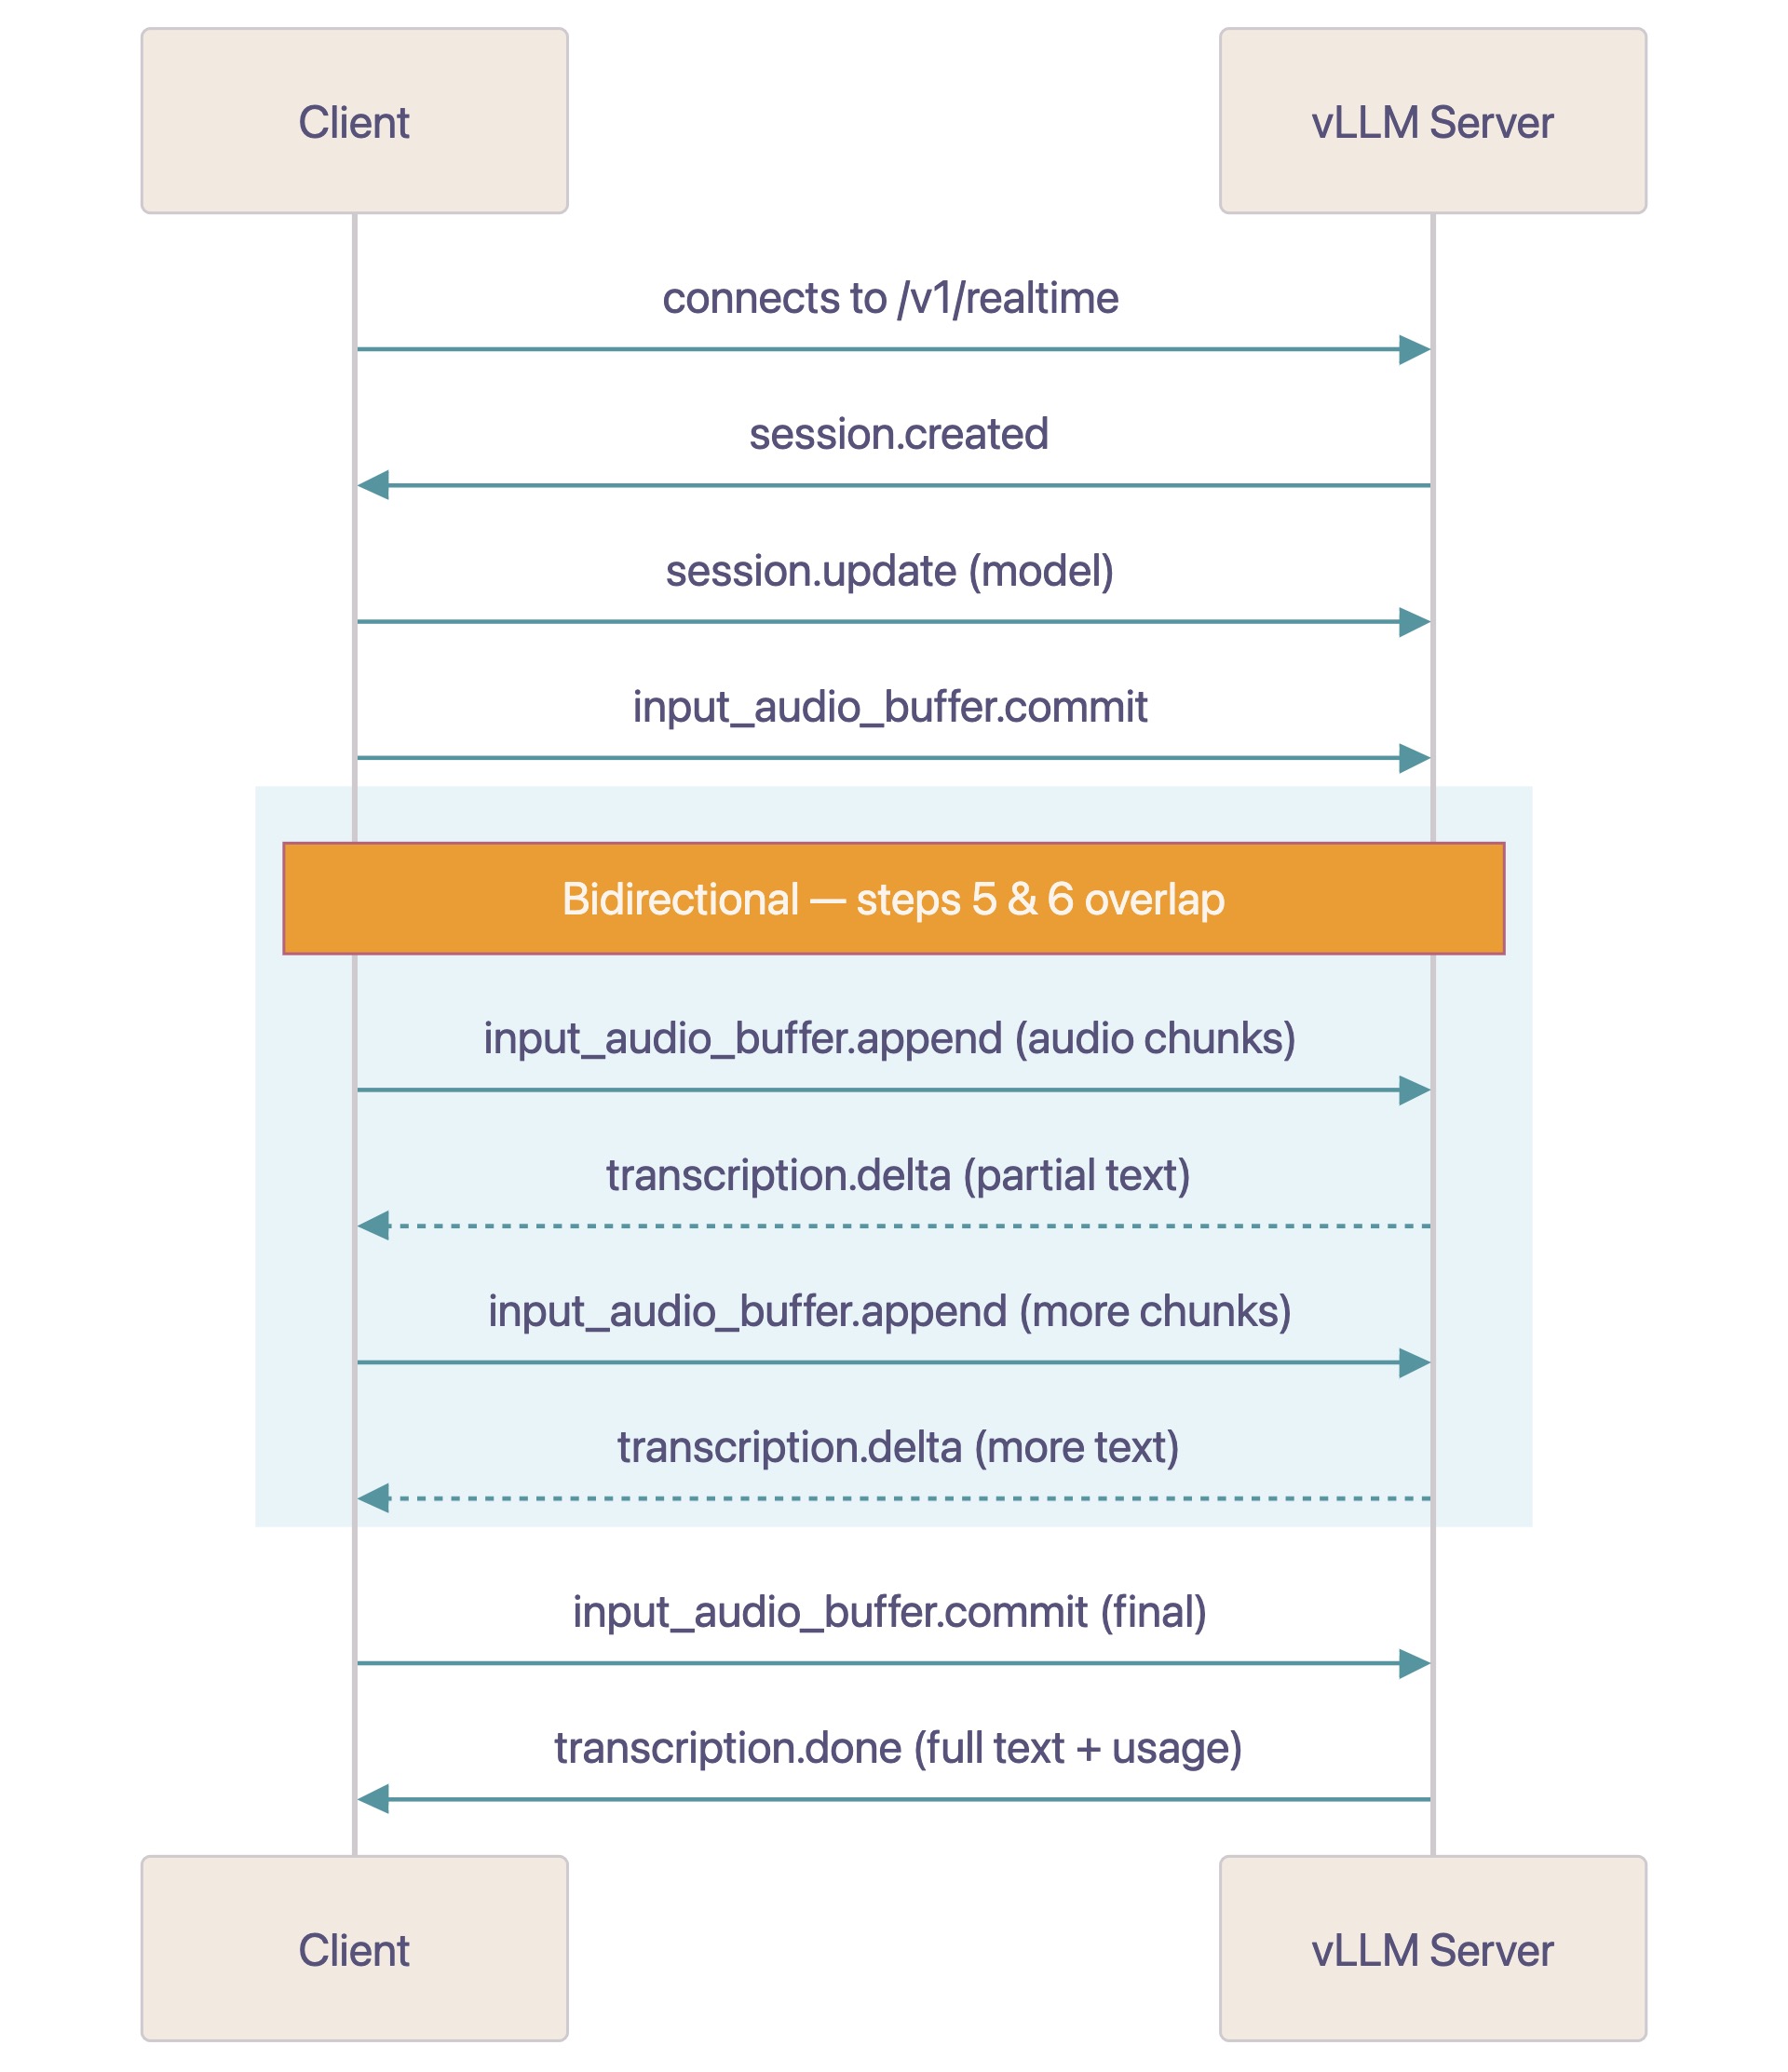
vLLM 的 Realtime API 采用 WebSocket 协议,提供基于音频流转录的实时能力 :
1. Client → Server: 连接到 ws://host/v1/realtime
2. Server → Client: 发送 session.created 事件
3. Client → Server: (可选)发送 session.update 配置模型参数
4. Client → Server: 发送 input_audio_buffer.commit 表示音频准备就绪
5. Client → Server: 发送 input_audio_buffer.append 事件(base64 PCM16 chunks)
6. Server → Client: 发送 transcription.delta 事件(增量转录文本)
7. Server → Client: 发送 transcription.done 事件(最终转录 + 使用统计)
8. 重复步骤5-7处理下一段语音
关键特性:模型在获得足够音频上下文后立即开始转录,在客户端继续发送音频 chunk 的同时就开始返回 transcription.delta tokens。客户端可发送 input_audio_buffer.commit 并设置 final=True 来标识音频输入结束,适用于音频文件流式传输场景。
核心组件详解
Voxtral-Mini-4B-Realtime-2602
Mistral AI 开发的紧凑型实时语音模型 :
- 参数量:4B(40亿参数),单 GPU 可部署
- 上下文长度:支持最长 262,144 tokens 的上下文,约等于 1 小时音频(3600秒 / 0.08秒每token)
- 实时性:增量处理音频块,输出转录 tokens
- 硬件需求:ml.g6.4xlarge(单张 NVIDIA L4 GPU)即可托管
vLLM Realtime API
vLLM 提供的原生 WebSocket 流式推理接口 :
- 端点:
/v1/realtimeWebSocket 路径 - CUDA Graph 优化:piecewise CUDA graph 执行模式减少 GPU kernel 启动开销,降低 per-token 延迟
- 音频格式:接收 base64 编码的 PCM16 音频(16kHz 单声道)
- 输出格式:JSON 格式的
transcription.delta事件,包含增量转录文本
SageMaker AI 双向流式推理
SageMaker AI 托管基础设施的核心能力 :
- 协议桥接:自动桥接客户端 HTTP/2 事件流与容器端 WebSocket 协议
- 端口:客户端连接 8443 端口
- 连接管理:ping/pong keepalive 帧(60秒间隔),5次无响应则关闭连接
- 健康检查:自动对容器进行健康检查
- 监控:通过 Amazon CloudWatch 提供端点级监控
FastAPI WebSocket Bridge
轻量级协议转换层(~50行代码),实现 SageMaker AI 预期路径到 vLLM 原生端点的路由 :
VLLM_WS_URL = "ws://localhost:8081/v1/realtime"

@ app.websocket("/invocations-bidirectional-stream")
async def websocket_bridge(sm_ws: WebSocket):
    await sm_ws.accept()
    async with websockets.connect(VLLM_WS_URL) as vllm_ws:
        async def sm_to_vllm():
            while True:
                message = await sm_ws.receive()
                if "text" in message and message["text"]:
                    await vllm_ws.send(message["text"])
                elif "bytes" in message and message["bytes"]:
                    await vllm_ws.send(message["bytes"].decode("utf-8"))

        async def vllm_to_sm():
            async for msg in vllm_ws:
                if isinstance(msg, str):
                    await sm_ws.send_text(msg)
                elif isinstance(msg, bytes):
                    await sm_ws.send_bytes(msg)

        await asyncio.gather(sm_to_vllm(), vllm_to_sm())
关键设计点:由于客户端设置 DataType="UTF8",SageMaker AI 传递 text frames 给 Bridge,无需帧类型转换。二进制解码 fallback 仅为未设置 DataType 的客户端准备。
部署流程详解
自定义 Docker 容器构建
基于 SageMaker AI vLLM Deep Learning Container 构建自定义镜像 :
FROM public.ecr.aws/deep-learning-containers/vllm:0.17.1-gpu-py312-cu129-ubuntu22.04-sagemaker-v1.0-soci

# 声明容器支持双向流式推理
LABEL com.amazonaws.sagemaker.capabilities.bidirectional-streaming=true

WORKDIR /opt/ml/code

# 安装 bridge 依赖
COPY requirements.txt .
RUN pip install --upgrade --no-cache-dir -r requirements.txt

# WebSocket Bridge 和入口脚本
COPY app.py .
COPY sagemaker-entrypoint.sh entrypoint.sh
RUN chmod +x entrypoint.sh

ENTRYPOINT ["./entrypoint.sh"]

HEALTHCHECK --interval=30s --timeout=10s --start-period=120s --retries=3 \
  CMD curl -f http://localhost:8080/ping || exit 1
关键 Docker Label:com.amazonaws.sagemaker.capabilities.bidirectional-streaming=true 是 SageMaker AI 识别双向流式容器的标志,缺少此 label 将导致 SageMaker AI 拒绝建立 WebSocket 连接。
环境配置与端点创建
vLLM 环境变量配置 :
vllm_env = {
    "SM_VLLM_MAX_MODEL_LEN": "45000",
    "SM_VLLM_COMPILATION_CONFIG": '{"cudagraph_mode": "PIECEWISE"}'
}
- MAX_MODEL_LEN=45000:支持约1小时音频的实时转录(3600秒 / 0.08秒每token)
- COMPILATION_CONFIG cudagraph_mode: PIECEWISE:启用 CUDA graph 优化提升推理吞吐
端点创建流程:Model.create() → EndpointConfig.create() → Endpoint.create() → wait_for_status("InService")
客户端实现
文件级转录客户端
sagemaker_bidi_client.py 封装双向流 SDK 的 SageMakerRealtimeClient 类 :
- 发送
session.update事件选择模型 - 以 4KB PCM16 chunk 流式发送音频文件
- 背景 asyncio.Task 运行接收循环,主协程发送音频 chunk
await asyncio.sleep(chunk_duration)控制发送节奏(~128ms/4KB at 16kHz),让接收任务有处理机会
实时麦克风客户端
sagemaker_bidi_microphone_client.py 基于 Gradio 的实时麦克风 demo :
- 从浏览器通过 Gradio streaming audio input 捕获麦克风音频
- 重采样至 16kHz PCM16
- base64 编码后通过 SageMaker AI 双向流发送
- 说话同时 UI 实时更新转录文本,无需等待说话结束
性能优化与生产考量
延迟优化
chunk size 是延迟与吞吐量的关键权衡点 :
| Chunk Size | 音频时长 | 延迟 | 开销 |
|---|---|---|---|
| 2 KB | ~64ms | 最低 | 高(更多消息) |
| 4 KB | ~128ms | 中等 | 中等 |
| 8 KB | ~256ms | 较高 | 低(更少消息) |
建议根据应用场景调整:低延迟需求选小 chunk,生产环境批量处理选大 chunk。
连接韧性
SageMaker AI WebSocket 连接管理细节 :
- Keepalive:ping/pong 帧每 60 秒发送
- 超时:5 次 ping 无响应则关闭连接
- 长会话:实现客户端重连逻辑,不要假设连接永久保持
- 错误处理:区分
ResponseStreamEventModelStreamError(模型级错误)和ResponseStreamEventInternalStreamFailure(平台级错误)
音频格式要求
vLLM Realtime API 严格要求输入格式 :
- 编码:base64
- 采样率:16 kHz
- 声道:单声道 mono
- 位深:PCM16
非标准格式音频需在客户端预处理后发送。
适用场景扩展
此架构不仅限于语音转文字,可扩展至以下场景 :
- 语音 Agent:多轮对话式 AI,结合 LLM 实现意图识别与响应生成
- 实时翻译:流式音频 → 转录 → 翻译 → 语音合成流水线
- 交互式音频生成:TTS 模型的双向流式调用
- 多轮流式对话:结合 text LLM 实现端到端语音对话系统
- 实时字幕:会议、直播等场景的低延迟字幕生成
清理与成本优化
SageMaker AI 端点按实例运行时长计费 :
- 删除 SageMaker AI Endpoint(最重要)
- 删除 Endpoint Configuration
- 删除 Model
- 删除 Amazon ECR 中的自定义容器镜像
- 删除 S3 中的模型 artifacts
深度分析
三层架构的协议正交性设计:该方案的核心工程价值在于每一层协议的完全解耦。Client ↔ SageMaker AI 使用 HTTP/2 + JSON(标准化),SageMaker AI ↔ Container 使用 WebSocket(标准化),Container 内部 FastAPI Bridge 仅做路径转换。三个协议层各自独立演进,任何一层的实现变更不会影响其他层。这种设计使得 vLLM 版本升级或 SageMaker AI 协议变更都可以独立进行,大幅降低了系统耦合度 。
双向流"同时性"的技术实现细节:文章揭示了一个关键实现细节——await asyncio.sleep(chunk_duration) 控制发送节奏,确保 HTTP/2 流的双向同时活跃。没有这个 sleep,客户端会全速发送chunk,使接收循环失去并发处理机会,看似双向实则串行。在生产系统中,任何涉及双向流的场景(语音、实时游戏、协作编辑)都需要类似的背压机制来保证真正的并发交互 。
Docker Label 是 SageMaker AI 双向流的唯一准入证:com.amazonaws.sagemaker.capabilities.bidirectional-streaming=true 这个 label 是 SageMaker AI 建立 WebSocket 连接的必要条件,缺少则直接拒绝连接。这是 SageMaker AI 的容器能力声明机制——与 Kubernetes 的 capabilities 类似,平台根据 label 决定是否向容器暴露特定能力。在扩展到其他 Realtime API 兼容模型时,首先检查该模型是否声明了 Realtime capability 是排查连接失败的首要步骤 。
FastAPI Bridge 的最小化设计原则:整个 Bridge 代码约 50 行,仅负责路径转换和消息转发,不涉及任何业务逻辑或数据处理。这种设计符合 sidecar 模式的核心原则——足够薄以至于几乎不会出错,且不需要单独的测试周期。Base64 解码的 fallback 分支(bytes→utf-8)仅在非标准客户端场景下激活,正文路径完全不经过该分支,体现了防御性编程与最小化意外路径的平衡 。
Gradio 流式音频捕获的工程参考价值:Gradio 的 streaming audio input 在浏览器端捕获原始音频流,通过 await asyncio.sleep(chunk_duration) 的发送节奏控制,实现说话同时显示转录文本。这为前端流式音频采集提供了一个可直接复用的工程范本,无需自研音频捕获模块。麦克风→重采样→base64→发送的完整链路可作为无障碍工具或实时字幕产品的参考架构起点 。
实践启示
1. 部署前必查 Docker Label:首次部署时若遇到 SageMaker AI 拒绝 WebSocket 连接,第一个排查点就是 LABEL com.amazonaws.sagemaker.capabilities.bidirectional-streaming=true 是否存在于 Dockerfile。在调试阶段,可通过 docker inspect 验证 label 是否被正确写入镜像。这一机制与 Kubernetes 的 capability gating 完全独立,是 SageMaker AI 特有的准入控制 。
2. 生产环境必须实现自动重连逻辑:SageMaker AI 的 ping/pong keepalive 间隔为 60 秒,5 次无响应后关闭连接。对于 7×24 运行的语音 agent,这意味着客户端需要感知连接断开并自动重建。实现时应使用指数退避避免风暴,并在重连成功后重新发送 session.update 以恢复会话状态。纯语音转文字场景可选择短会话规避这一问题 。
3. 客户端音频处理链路标准化:vLLM Realtime API 严格要求 16kHz 单声道 PCM16 base64,任何非标准格式都必须在前端完成转换。建议将音频预处理封装为独立函数,接收任意格式 AudioBlob,返回标准化 PCM16 chunks,以便在不同输入源(麦克风、电话 PCM、浏览器 MediaRecorder)间复用同一处理逻辑 。
4. 延迟敏感场景选 2KB chunk,吞吐优先场景选 8KB:2KB 对应 ~64ms 音频,是语音对话的最小感知单元(人类语音音节通常 >100ms),适合语音 agent 和无障碍转录;8KB 对应 ~256ms,适合录音后处理或直播字幕等可容忍轻微延迟的场景。在 Whisper 等非流式模型对比下,4KB chunk 在延迟和开销之间取得平衡,可作为默认初始配置 。
5. 端点删除是成本控制的第一优先级:SageMaker AI 按实例运行时长计费,端点不删除即持续计费。部署完成后应立即验证功能,随后执行完整的清理流程(端点→配置→模型→ECR→S3)。在原型验证阶段,可使用 wait_for_status("InService") 后立即调用一次测试,然后执行清理,避免端点长时间空转产生费用 。
相关资源
- GitHub: sagemaker-genai-hosting-examples
- vLLM Realtime API 文档
- SageMaker AI 双向流式推理介绍
- Voxtral-Mini-4B-Realtime-2602 on HuggingFace
- aws-sdk-sagemaker-runtime-http2 Python 包
扩展阅读
→ 原文存档 → Voice Agent 设计 - Nova Sonic 多 Agent 工具与会话 → Nova Sonic WebRTC 实时语音流 → OpenAI Realtime Voice 架构