使用 Amazon S3 Tables 优化数据湖:从Hudi 迁移到托管 Iceberg
📊 Level ⭐ | 9.2KB
→ 原文存档
使用 Amazon S3 Tables 优化数据湖:从Hudi 迁移到托管 Iceberg
摘要:某零售品牌因 Hudi 0.12.x 版本老化、并发冲突和全量覆盖场景低效,迁移至 Amazon S3 Tables。团队采用混合策略:DW 层用 S3 Tables 实现增量 MERGE,DM 层全量覆盖表直接写 Parquet。通过新旧并行分批迁移,最终核心作业性能提升最高 8 倍,ETL 月度成本降低 72%。
目录
01 一、引言
02 二、Amazon S3 Tables 介绍
03 三、面临的挑战
04 四、解决方案:S3 tables + 按场景选格式的混合架构
05 五、性能对比
06 六、成本效益
07 七、数据质量验证
08 八、经验总结
09 九、相关服务
一、引言
某全球领先的零售品牌在 AWS 中国区运营着支撑核心业务的数据湖平台。随着数据规模增长,基于 Apache Hudi 0.12.x 构建的 ETL 管道面临版本老化、并发写入不稳定、运维复杂度高等挑战。本文介绍该客户如何通过迁移到 Amazon S3 Tables(AWS 原生托管的 Apache Iceberg 服务),结合按场景选择最优存储格式的混合策略,实现关键作业性能提升最高达 8 倍、ETL 月度成本降低 72%。
二、Amazon S3 Tables 介绍
Amazon S3 Tables 是 AWS 提供的托管 Apache Iceberg 表存储服务。它将 Iceberg 表格式的开放性与 S3 的规模和持久性相结合,为分析工作负载提供原生的 ACID 事务、Time Travel 和与 AWS 分析服务(Athena、Redshift、Glue)的深度集成。
S3 Tables 提供了一条低运维的迁移路径——无需自建 Hive Metastore 或管理 Iceberg Catalog,AWS 原生处理元数据管理和查询集成。
目前Amazon S3 Tables在中国区两个区域均可使用。
三、面临的挑战
客户的数据湖平台包含数十个 Airflow DAG 和数百个 AWS Glue 作业,采用 ODS / DW / DM 三层架构。核心事实表日增量约数千万行,下游驱动近 20 个分析宽表为 BI 报表提供数据。
使用 Apache Hudi 0.12.x 面临的核心挑战:
- 版本老化风险:Hudi 0.12.x 社区已停止积极维护,跨大版本升级到 0.14 或 1.0 需要大量兼容性测试,且有数据格式不兼容的风险。
- 并发写入不稳定:HiveSyncTool 在多个作业并发写入同一表时频繁报冲突错误,导致关键 Trend 类作业必须降低并行度才能稳定运行。
- DM 层架构不匹配:近 20 个 DM 表中绝大部分为全量覆盖模式(每次运行重算整表),但 Hudi 仍然使用 MERGE 语义——先读目标表再写入,产生不必要的 IO 开销。
- 计算资源利用率低:受上述问题影响,部分大表作业需分配数百 DPU 才能在可接受时间内完成。
四、解决方案:S3 tables + 按场景选格式的混合架构
4.1 方案核心
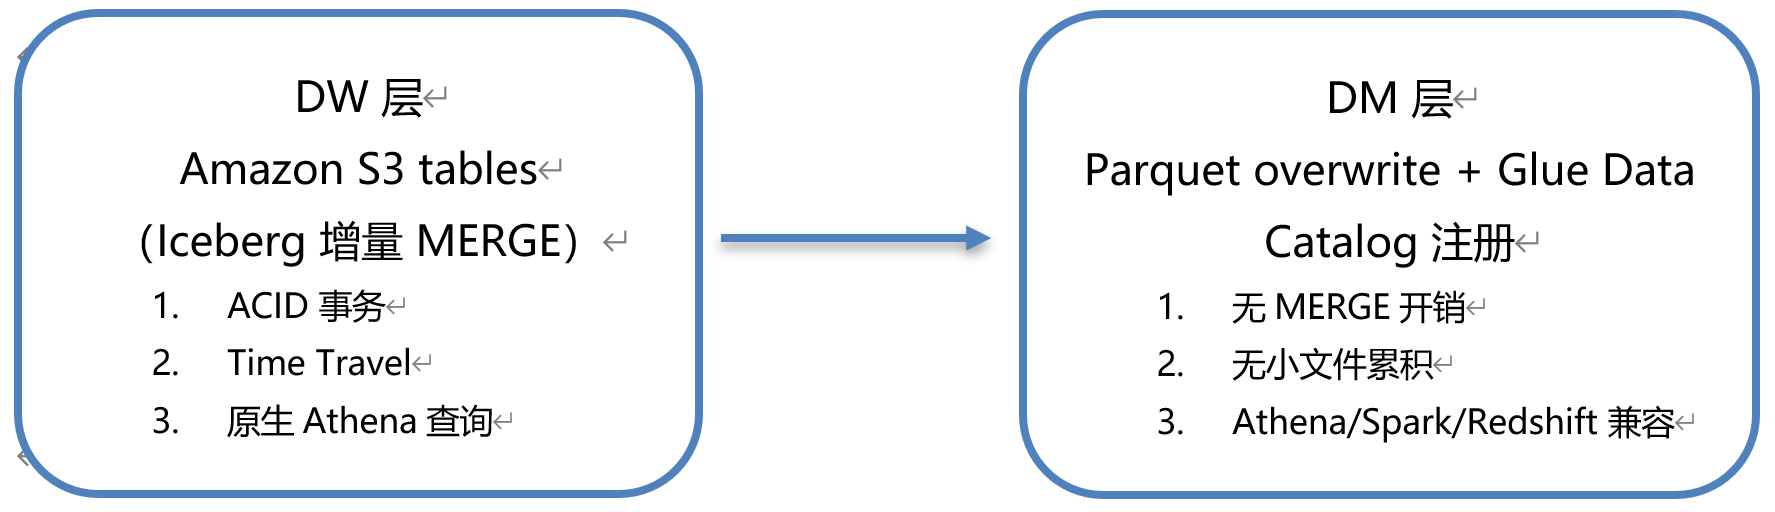
我们并没有简单地将所有表”从 Hudi 换到 Iceberg”,而是根据每张表的实际写入模式做了差异化选择:
数据层 | 写入模式 | 格式 | 理由
---|---|---|---
DW 层 | 增量 MERGE(upsert) | Amazon S3 Tables | 需要 ACID、Time Travel、增量合并能力
DM 层 | 全量覆盖(overwrite) | Parquet 直写 + Glue Catalog | 无需 MERGE,极简高效,避免小文件
DM 层 | 增量 upsert | Amazon S3 Tables | 唯一需要增量合并的 DM 表
4.2 为什么选择 Amazon S3 Tables而非自建 Iceberg
功能 | 自建 Iceberg | Amazon S3 Tables
---|---|---
Catalog 管理 | 需自建 Hive Metastore 或配置 Glue Catalog 同步 | 原生集成,零配置
Athena 查询 | 需额外配置 | 直接 SQL 查询
运维复杂度 | 自行管理版本、元数据一致性 | AWS 托管
4.3 迁移策略:新旧并行,30天稳定后切换
为每个需要迁移的作业新建独立版本,旧 Hudi 版本完全不动。新版本在验证环境稳定运行 30 天后,可下线旧版。这个迁移策略可保:1. 零停机:新旧版本并行运行,业务无感知;2. 可回滚:旧版始终可用,发现问题立即切回; 3. 可验证:同源数据双跑,结果可逐行对比。
分批执行
| 批次 | 范围 | 说明 |
|---|---|---|
| 第一批 | 核心事实表 DW → 全部下游 DM | 风险最高、价值最大的链路先行验证 |
第二批 | 核心表上游 ODS 层 | 第一批稳定后接续
第三批起 | 其余业务链路 | 依前批验证结果逐步解锁
4.4 S3 tables 实践经验
4.4.1 小文件管理
Amazon S3 Tables 每次增量提交都会产生新数据文件。如果不加控制,频繁的增量写入会导致大量小文件(实测首次全量写入曾产生数千个 ~9 MB 文件),显著影响后续查询性能。
解决方案:
1. 调整分区粒度:从 year/month/day 改为 year/month,减少分区数量
2. 显式 repartition:写入前手动控制输出文件数量和大小
# 写入前显式控制文件大小,目标 200-256 MB/文件
partition_fields = ["year", "month"]

df = df.repartition(*[col(f) for f in partition_fields])
3. 定期 Compaction:配置每周调度合并小文件
Compaction 调度示例(每周日凌晨),优化后单文件平均大小从 9 MB 提升到 224 MB。
4.4.2 write.distribution-mode 配置注意事项
在 S3 Tables 中使用 createOrReplace 方式写入
关联
- 相关概念: Harness Engineering